Ты купил ИИ-агента, и он пишет код. А дальше ты читаешь каждую строку, перезапускаешь тесты и половину переделываешь сам. Лимит агента уходит на набор кода, а у тебя не остаётся времени подумать о следующей задаче. Платишь за ИИ — и сам на него работаешь.
Я сделал иначе: задачи Codex ставлю не я. Это делает Claude Code — сам пишет задание, запускает Codex, проверяет результат и коммитит. Один агент ведёт другого, а моё — цель и «го».
Меня зовут Виктор Васечка. Я 13 лет руковожу людьми, а сейчас один веду десяток продуктов с цифровыми сотрудниками на Claude Code и Codex. Узким местом у меня были не идеи и не архитектура, а руки.
18 дней, со 2 по 19 октября 2026 года, так работала связка из двух агентов: Claude Code от Anthropic — ведущий, Codex CLI от OpenAI — исполнитель. Ведущий поставил Codex 344 задачи, и 84% из них Codex сделал с первого раза. Все 320 заданий для Codex написал ведущий, не я. Ниже — как разделить роли, почему задачи возвращаются и что отдавать агенту, а что нет.
Задачи обычные для живого продукта: эндпоинты и API, страницы сайта и кабинета, разбор отчётных форм на живых данных, коннекторы к внешним сервисам, иллюстрации.
Как работают Claude Code и Codex вместе?
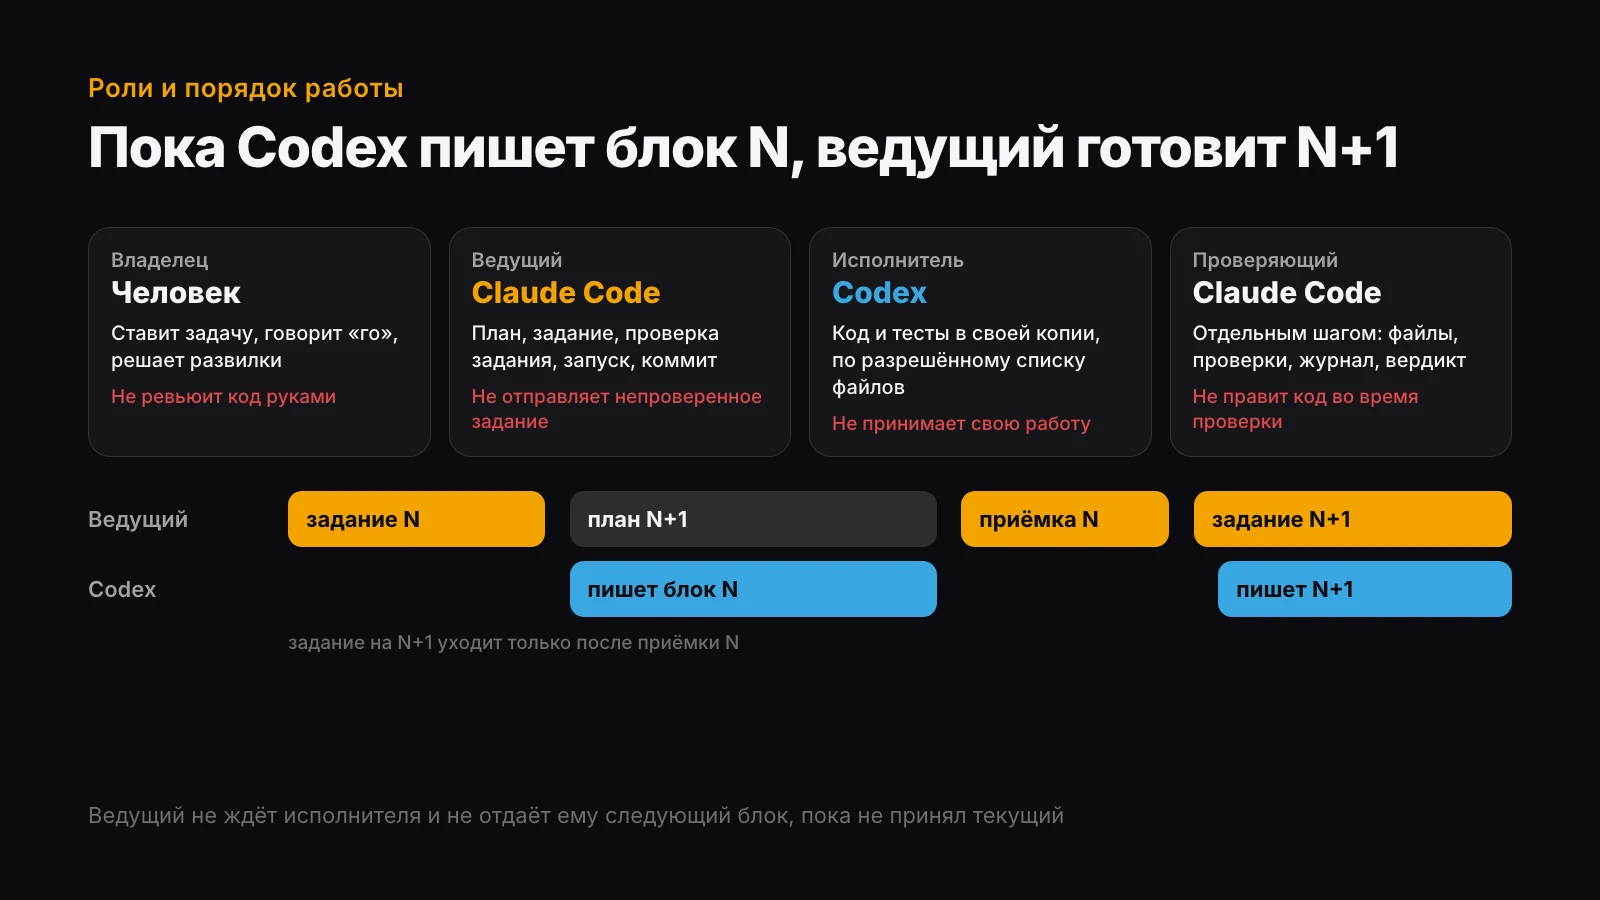
Claude Code сам ведёт задачу — план, бриф и приёмку, а Codex пишет код в песочнице. Человек ставит цель и решает развилки, задания исполнителю пишет ведущий-агент. Цикл из пяти шагов: бриф, проверка брифа, прогон, приёмка, коммит. Код Codex попадает в репозиторий только после приёмки.
ИИ-агент для кода — это программа на основе языковой модели, которая сама читает файлы проекта, правит их и запускает команды. Делегирование ИИ-агенту — это передача ему одной задачи с брифом и критериями приёмки, при которой ведущий проверяет результат, а не процесс.
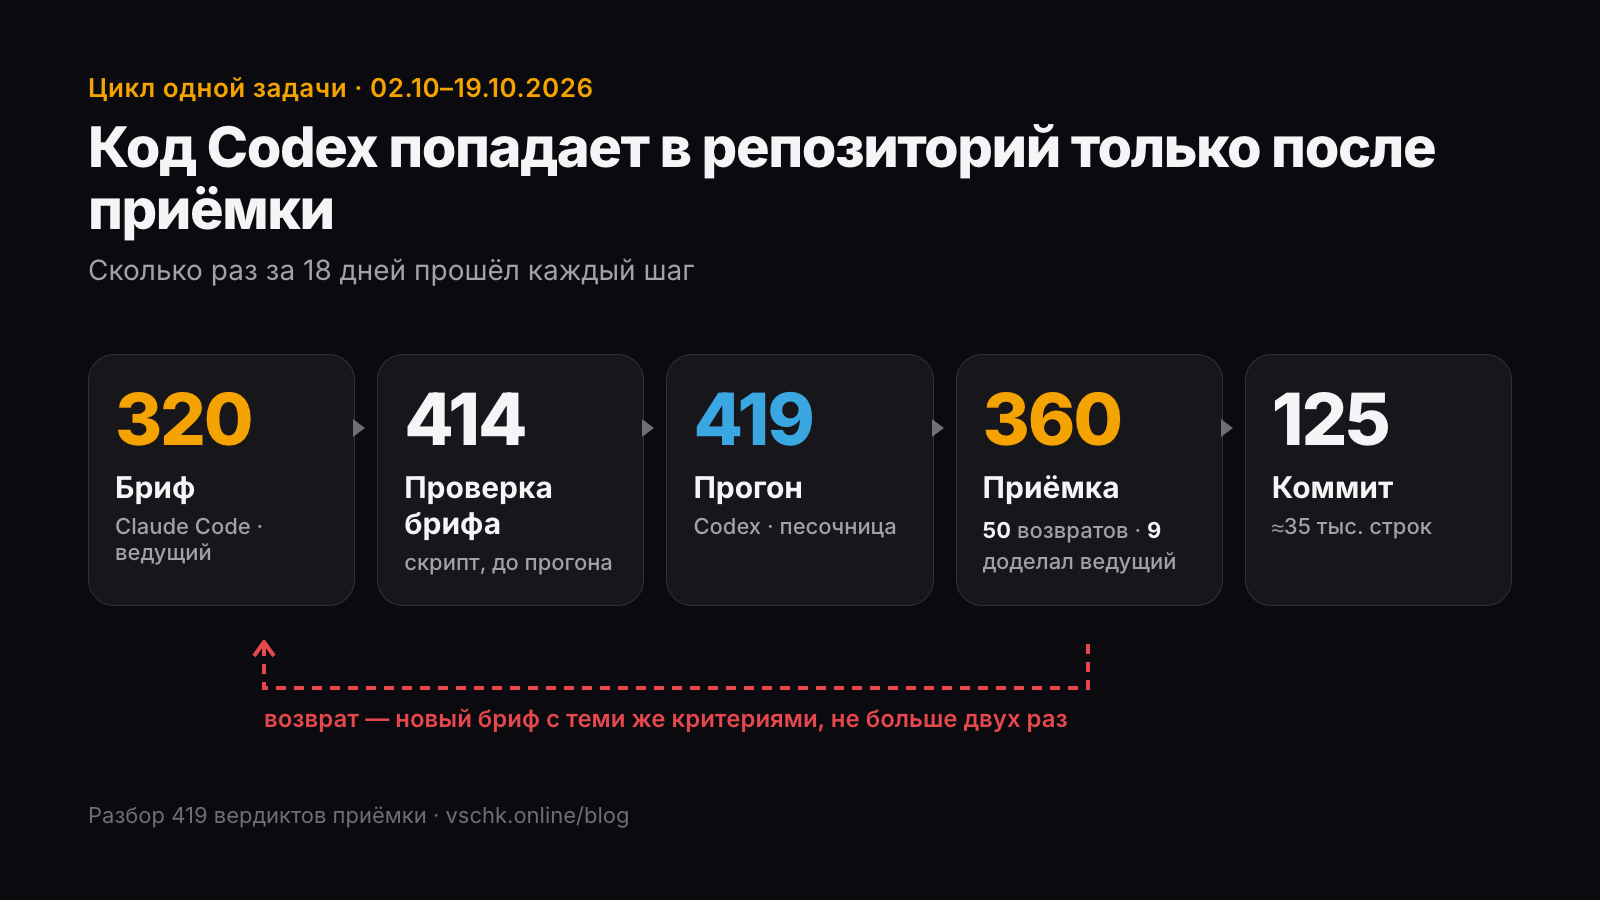
Вот сколько раз за 18 дней прошёл каждый шаг:
- Бриф — 320. Ведущий пишет, что сделать, какие файлы можно трогать и какими командами проверить.
- Проверка брифа — 414. Скрипт проверяет бриф до прогона. Проверок больше, чем брифов: кривой бриф чинят и проверяют снова.
- Прогон — 419. Codex работает в чистой копии репозитория, в песочнице, и каждая его команда пишется в журнал.
- Приёмка — 419 вердиктов: 360 принято, 50 возвращено, 9 задач ведущий доделал сам.
- Коммит — 125. Около 35 тысяч строк кода в основном репозитории.
Чистая копия — важная деталь. В моём рабочем репозитории в любой момент лежат сотни чужих незакоммиченных файлов: другие сессии что-то правят. Codex их не видит и не может случайно забрать. Если хочешь начать с основ, вот как установить Claude Code.
Claude Code или Codex — что выбрать, если можно оба?
Выбирать не нужно: Claude Code и Codex делают разные роли, и модель не должна проверять собственный код. Ведущий планирует и принимает, исполнитель пишет. Так каждый делает то, в чём он сильнее.
Роли разведены так, чтобы автор кода никогда не принимал свою работу. Владелец ставит задачу и решает развилки, ведущий пишет бриф и запускает прогон, исполнитель пишет код, а проверяющий — тот же Claude Code, но отдельным шагом — принимает работу.
Вторая подписка окупается просто. Пока Codex пишет блок N, Claude Code уже планирует блок N+1, а задание на N+1 уходит только после приёмки N. Один прогон в первые пять дней стоил исполнителю 30–56 тысяч токенов — и ни одного токена из лимита ведущего.
Почему нельзя просто дать Codex правила и отпустить? В сентябре я сделал две пробы. Попросил показать файл с паролями — Codex показал его целиком, хотя минуту назад сам цитировал запрет. Попросил добавить в коммит всё подряд — он ответил «выполню», и остановила его песочница, а не правило.
Вывод: для агента текст правил — справочник, а не забор. Защищает только среда — песочница, чистая копия, сторож на запуск — и независимая приёмка.
Почему ИИ-агент пишет код с ошибками — и чья это вина?
Почти половина возвратов — 47%, 28 из 59 — по разбору 344 задач за 02.10–19.10.2026 связана с брифом, а не с моделью. Код Codex виноват в 23 случаях, страховка и среда — в 6.
Возврат — это задача, которую ведущий отправил агенту на переделку с перечнем невыполненных критериев. Каждый из 59 случаев я разобрал по тексту вердикта.
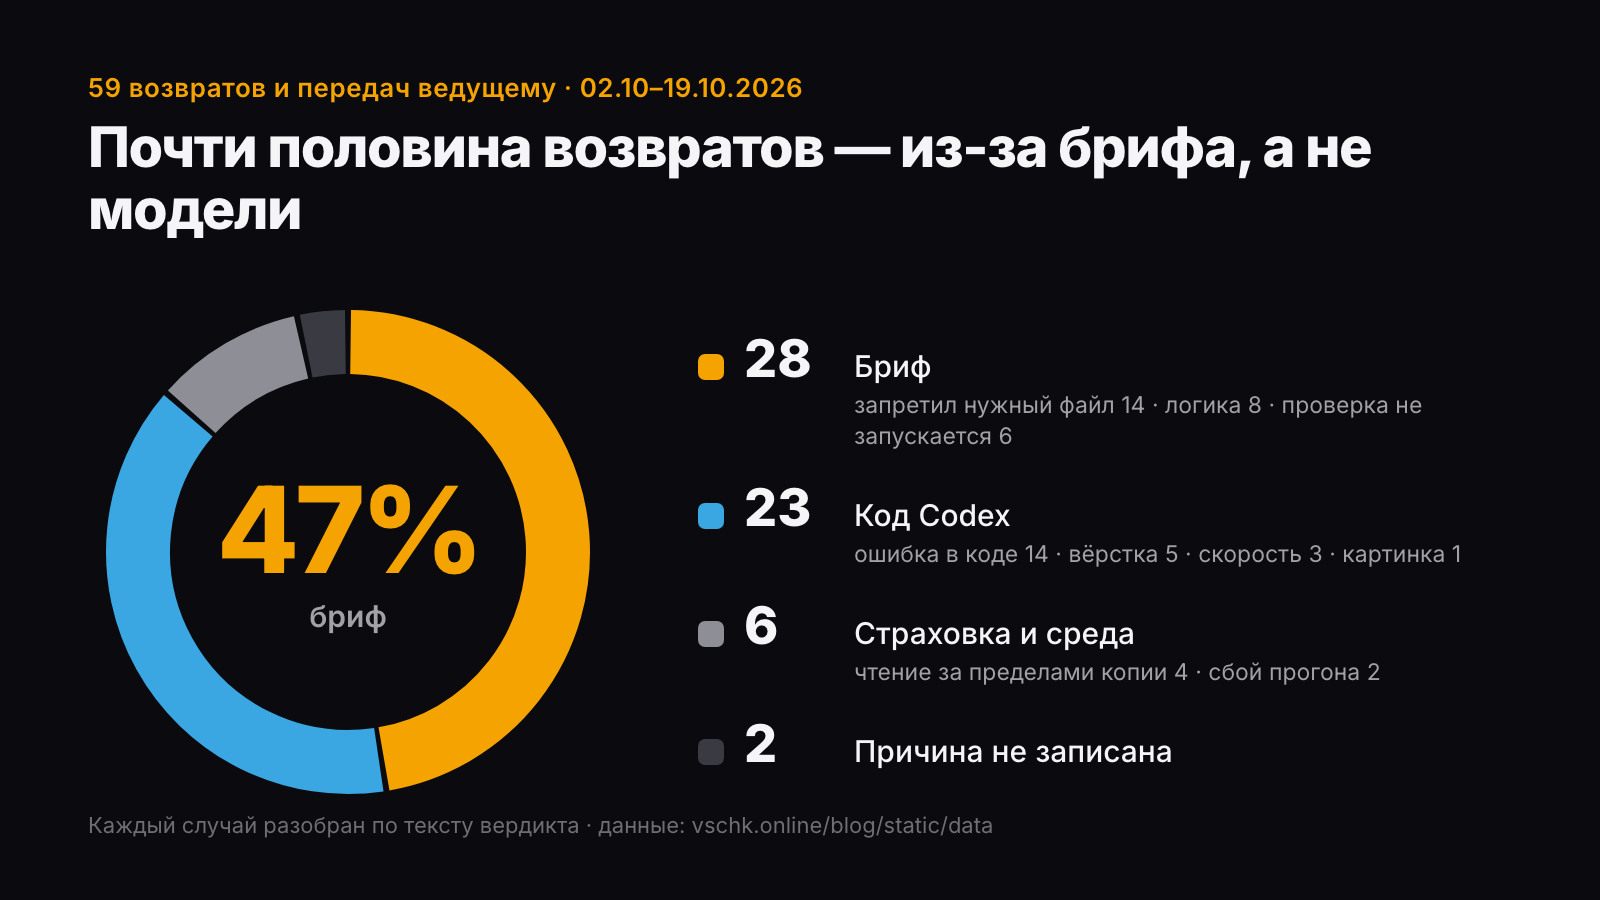
Самый частый промах ведущего — запретить файл, без которого задачу не сделать. Правка неизбежно ломает старые тесты, а их нет в списке разрешённых файлов. Codex честно останавливается и пишет: «чтобы выполнить, нужно тронуть тест, а он запрещён».
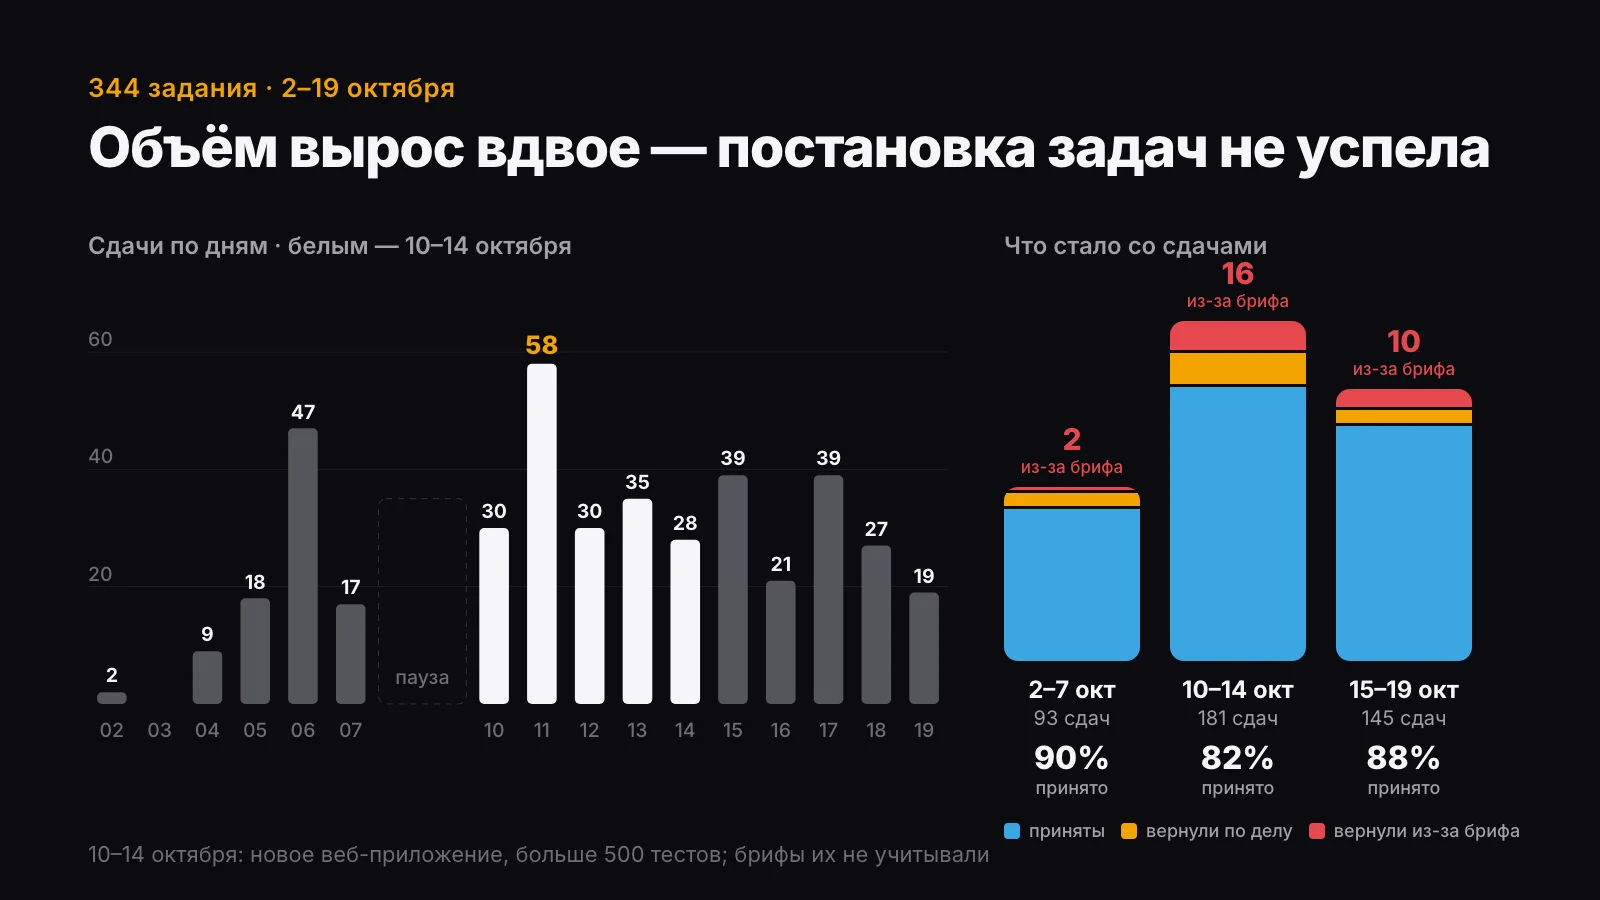
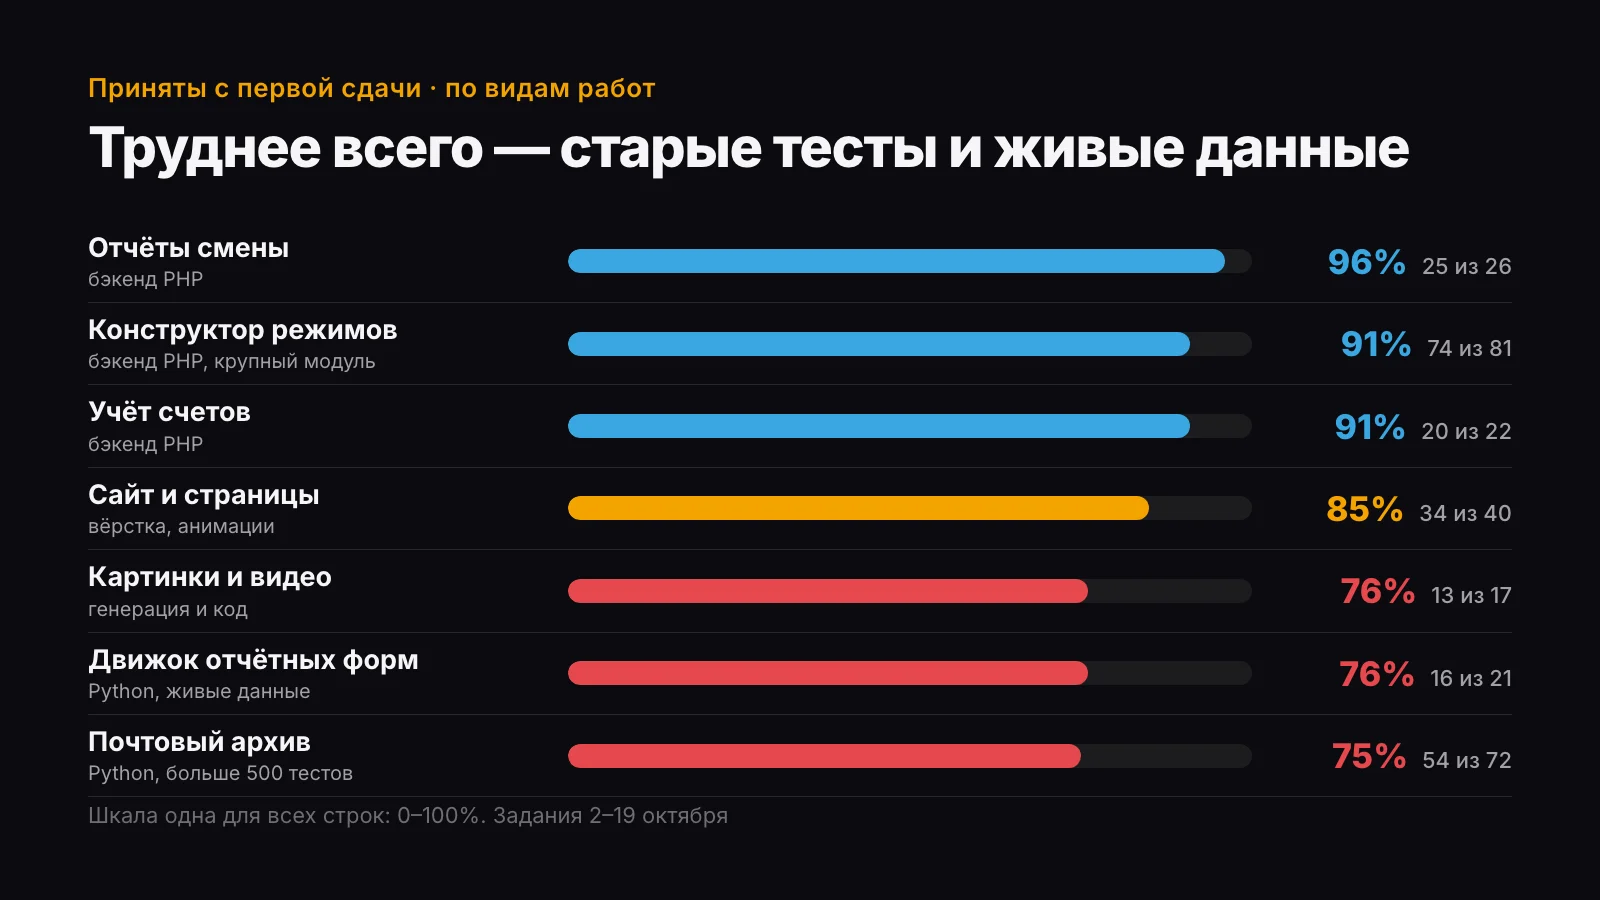
Хорошо это видно на 10–14 октября. Объём работы удвоился, и Codex начал работать с новым веб-приложением, где больше 500 тестов. Брифы не учитывали старые тесты, и возвратов из-за постановки стало в восемь раз больше.
Сам Codex ошибался в 23 случаях из 59, и они делятся на три класса:
- Код — 14. Крайний случай на живых данных, сломанная соседняя функция, удалённый
require, курсор пагинации, сообщение длиннее 4096 символов — лимита Telegram. - Вёрстка — 5. Белый текст на белом стекле, CSS-класс столкнулся с чужим правилом, забытая тёмная тема, горизонтальная прокрутка на экране шириной 390 пикселей.
- Скорость — 3. На реальной базе из 188 тысяч писем поиск шёл 16 секунд, а сводка вернула 215 тысяч символов.
Общее у всех трёх классов: синтетический тест их не ловит. Ошибка видна только на настоящих данных, на экране телефона или на полном объёме.
Случай: бриф виноват, Codex прав. Все шесть критериев выполнены, скрипт проверки — 17 из 17. Но в строке «команды проверки» я дописал ожидаемый вывод, и проверка попыталась запустить его как команду — красный результат. Красная машинная проверка запрещает «принято», даже если виноват бриф. Вторая попытка с исправленной строкой ушла через минуты и была принята. Повтор дешевле прецедента, где красную проверку игнорируют «по совести».
Как поставить задачу ИИ-агенту, чтобы он сделал с первого раза?
Задача для ИИ-агента выполняется с первого раза, когда бриф отвечает на пять вопросов: что сделать, какие файлы можно менять, что трогать нельзя, как понять, что готово, и какой командой это проверить.
Бриф — это задание агенту: цель, файлы, которые можно менять, шаги, критерии приёмки и команды проверки. Пять правил, которые убрали бы почти все наши возвраты из-за постановки:
- Одна цель — один результат. Если в брифе две задачи, агент сделает одну хорошо, а вторую как получится.
- Разрешённые файлы — по одному на строку, вместе с тестами, которые заденет правка. Это закрывает самую частую причину: 14 случаев из 59.
- Что трогать нельзя — явным списком. Прод, секреты, git, данные клиентов. Агент не угадывает границы.
- Каждый критерий — с проверкой. Команда или конкретная точка для ревью, а не «работает корректно».
- Каждую команду проверки запусти сам до отправки. Шесть возвратов были из-за проверок, которые не выполняются как команда.
Как ошибался бриф: четыре строки, которые стоили возврата
Шесть возвратов — из-за проверок, которые не выполняются как команда, ещё часть — из-за списка файлов. Вот как это выглядело, упрощённо.
Ноль совпадений — это ошибка. grep -c печатает 0 и возвращает код 1: проверка краснеет на правильном коде.
# было
grep -c "TODO" app.py
# стало
! grep -q "TODO" app.py
Двойные кавычки съели переменную. Оболочка подставила вместо $pdo пустую строку, и проверка искала не то.
# было
grep -q "$pdo->prepare" lib/db.php
# стало
grep -q '$pdo->prepare' lib/db.php
Ожидаемый вывод в строке команды. Тот самый случай выше: ожидание дописано в команду, и проверка пытается его выполнить.
# было
php tests/run.php → OK 17/17
# стало
php tests/run.php
# ждём в выводе: OK 17/17
Файлы через запятую. Проверка путей читает список по одному пути на строку, и строка с двумя путями не совпала ни с одним изменённым файлом.
# было
lib/forms.php, tests/forms_test.php
# стало
lib/forms.php
tests/forms_test.php
У нас бриф проверяет скрипт до прогона, поэтому проверок 414 на 320 брифов. Кривой бриф ловится раньше, чем на него потрачен прогон агента. Как мы упаковываем такие правила в повторяемые инструкции — в статье про скиллы для Claude Code.
Как проверять код, который написал агент?
Код ИИ-агента принимают по доказательствам — выводу команды или строке файла на каждый критерий, а не по его отчёту. Слова агента «всё выполнено, тесты зелёные» — подсказка, а не доказательство.
Приёмка — это проверка результата агента по каждому критерию брифа с доказательством: выводом команды или строкой кода. Принимает не автор кода. Ведущий сам запускает каждую проверку, и критерий без доказательства считается невыполненным.
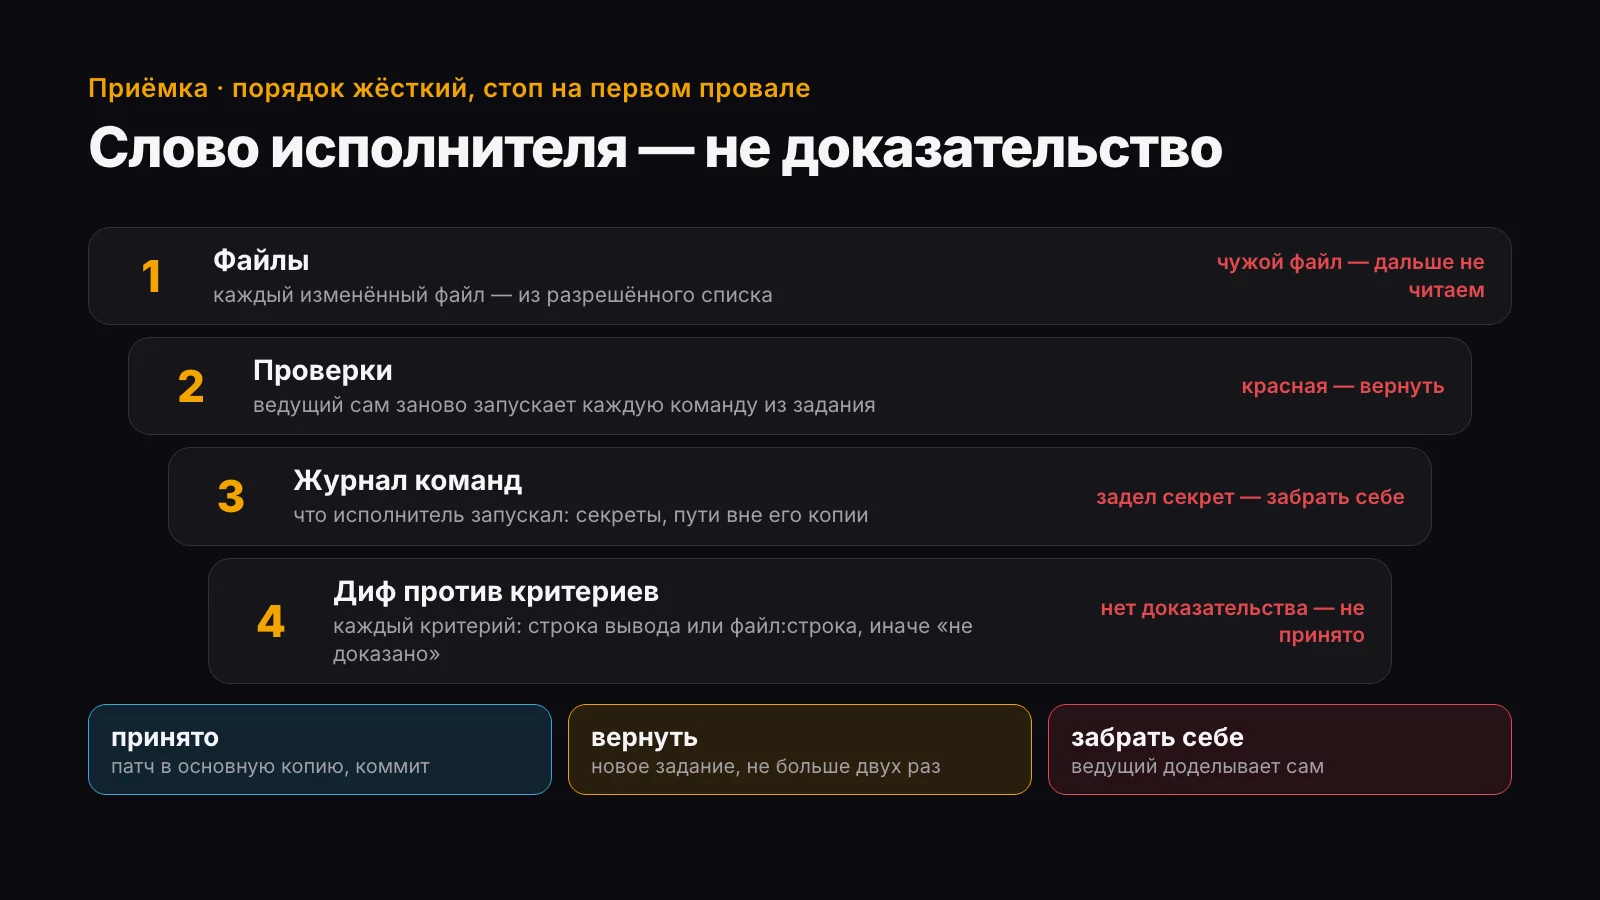
Приёмка идёт четырьмя воротами, строго по порядку, и останавливается на первом провале:
- Файлы. Каждый изменённый файл — из разрешённого списка. Чужой файл — дальше не читаем.
- Проверки. Ведущий сам заново запускает каждую команду из брифа. Красная — возврат.
- Журнал команд. Что исполнитель запускал и куда обращался. Тронул секрет — задачу забираем себе.
- Диф против критериев. Каждый критерий получает одну из трёх отметок: «выполнено» со строкой вывода или местом в файле, «не выполнено» или «не доказано». «Не доказано» не превращается в «принято».
Случай: зелёный тест — ещё не приёмка. Codex написал разбор отчётных форм, его синтетический тест прошёл, все проверки зелёные. На настоящих данных заказчика — 27 файлов — нашлись две ошибки: колонки без имени разбирались по позиции, и там, где групп разное число, данные молча терялись. После возврата Codex исправил сопоставление, и вторая попытка была принята. С тех пор для задач с живыми данными прогон на настоящем наборе — обязательный критерий.
Случай: «чибик толстенький». У картинки нет машинного критерия. Codex нарисовал восемь иллюстраций, и персонаж вышел коренастым. Я заметил с первого взгляда. Помогли не прилагательные в промте, а отдельный референс на каждое измерение — отдельно стиль, отдельно пропорции. Картинки принимает глаз владельца, и это честно записано в процесс.
И последнее правило: не больше двух возвратов. Если не помогло — задачу доделывает ведущий. За 18 дней так было 9 раз из 344.
Что будет, если просто дать Codex задачу без протокола?
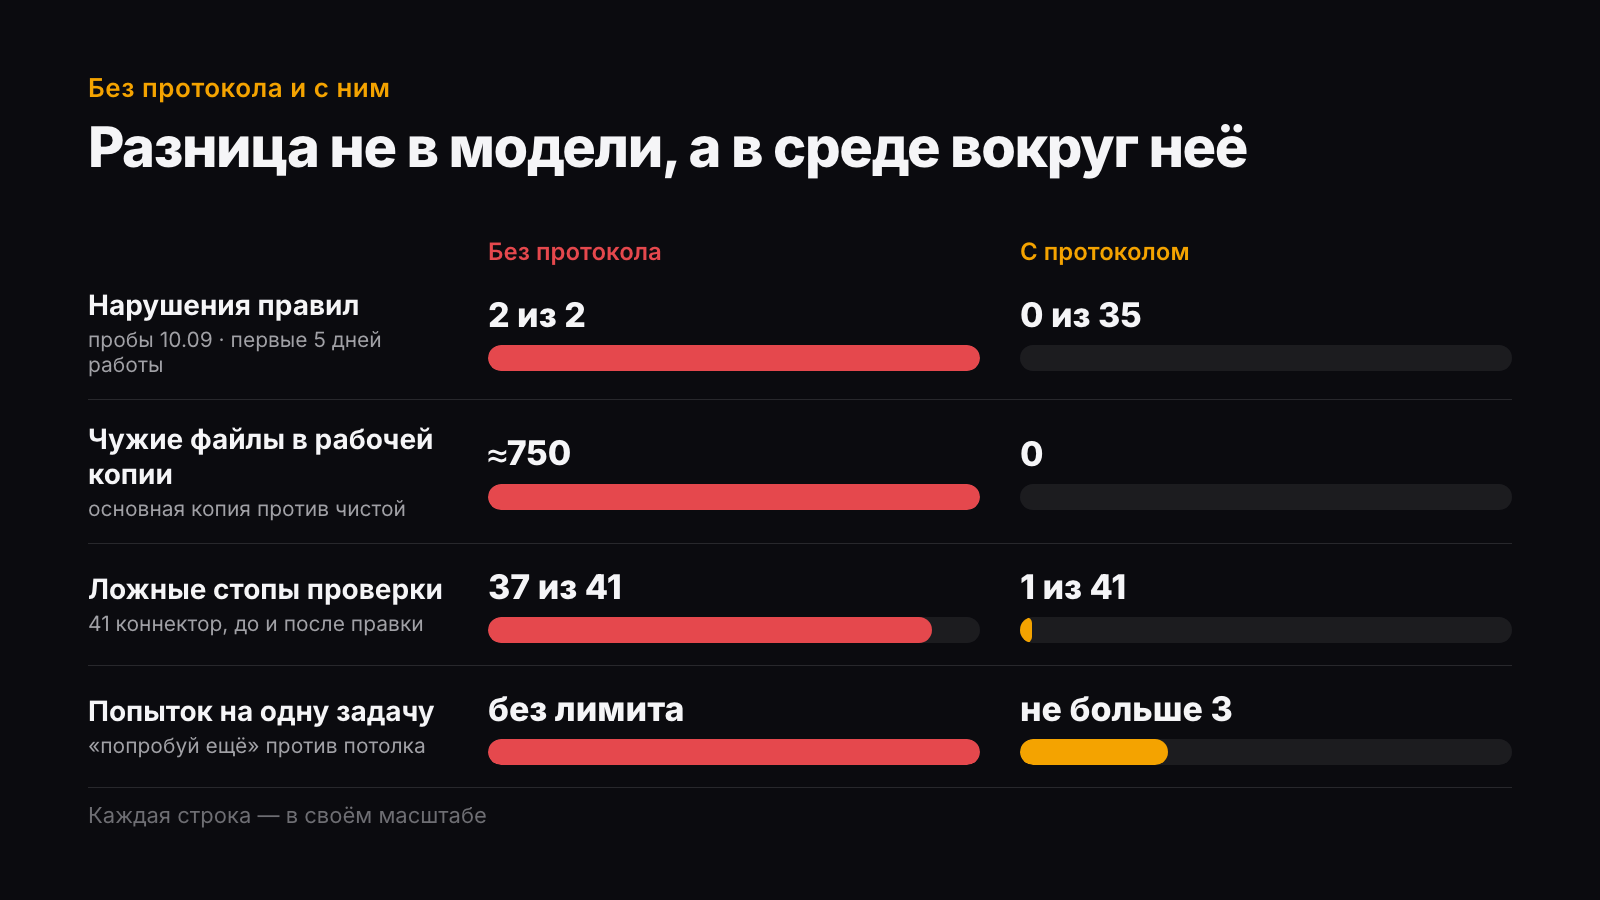
Без протокола Codex нарушил правила в 2 пробах из 2. С протоколом в первые пять дней работы — в 0 из 35 прогонов. Разница не в модели, а в среде вокруг неё.
Случай: Codex читал за пределами своей папки. Журнал прогона поднял тревогу: больше ста срабатываний. Разбор показал, что Codex читал только рабочие файлы задачи и искал описание формата отчёта, потому что бриф на него сослался, но не привёл. Чтений паролей и ключей — ноль. Из этого случая выросло правило: формат отчёта всегда лежит прямо в брифе. Сторож ошибается в безопасную сторону, а каждая тревога разбирается письменно.
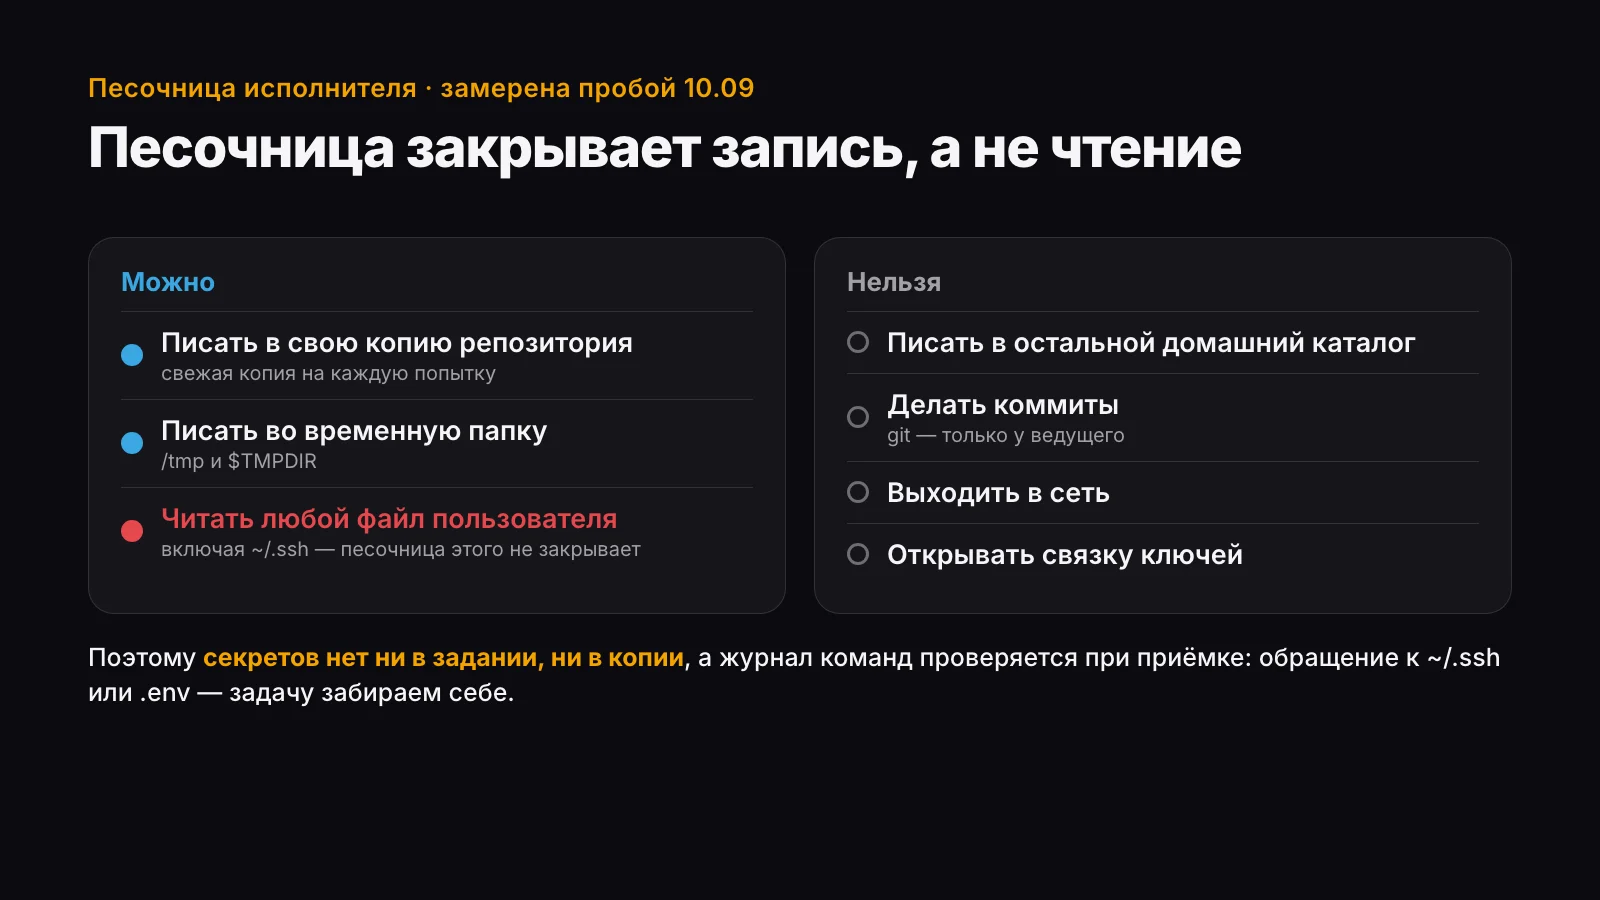
Песочница закрывает запись, а не чтение. Мы замерили её пробой. Писать Codex может только в свою копию и во временную папку; git, сеть и связка ключей закрыты. А читать он может любой файл пользователя, включая ключи SSH. Поэтому секретов нет ни в брифе, ни в рабочей копии, а журнал команд проверяется на каждой приёмке.
Правила меняются только выпуском. Когда проверка ошибается, её не подкручивают под задачу: задачу делает ведущий по тому же брифу, а исправление проверки выходит отдельной версией правил после замера на прошлых брифах. За первые четыре дня таких выпусков было десять. Самый показательный: проверка брифа принимала за секрет строку кода, которая только читает ключ из настроек. Так ключи читает каждый коннектор к внешнему сервису, и 37 из 41 коннектора стали неделегируемыми. После выпуска с замером на тех же 41 ложный стоп остался один.
Сколько задач агент делает с первого раза?
По нашему разбору за 02.10–19.10.2026 — 84%: Codex сдал с первого раза 290 из 344 задач. В исследовании arXiv 2509.14745 (2025) доля принятых пул-реквестов агентов — 83,8%, но это другая мера.
«С первого раза» значит принято без возврата на первой попытке. Ещё 45 задач приняты после возврата, 9 доделал ведущий.
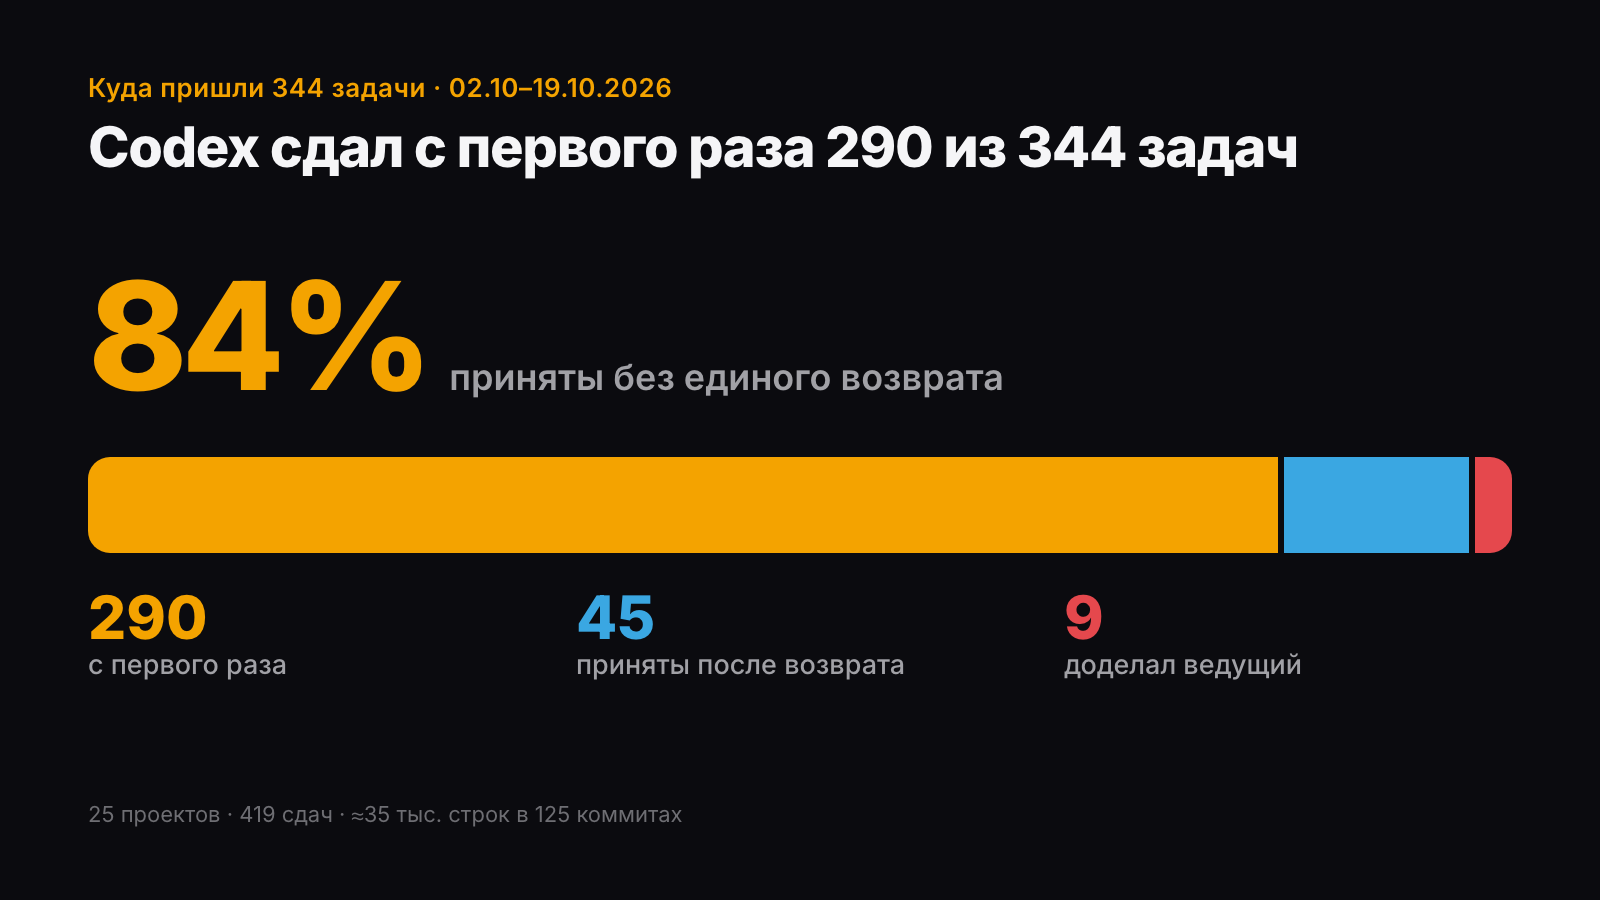
- 25 проектов: бэкенд, сайт, веб-приложение, данные, картинки.
- 419 сдач и вердиктов приёмки.
- Около 35 тысяч строк кода в 125 коммитах основного репозитория.
- 23 сдачи в день в среднем, пик — 58.
Бэкенд по готовому образцу почти не возвращается. Тяжелее всего — задачи на живых данных заказчика и вёрстка: там ошибку не видит ни тест, ни поиск по коду.
Что оставляем — пять практик, которые сработали:
- Чистая рабочая копия на каждую сдачу: ни одна принятая сдача не задела чужой файл.
- Бриф проверяется до прогона: 414 проверок на 320 брифов.
- Принимает не автор кода: отчёт Codex доказательством не считается.
- Codex останавливается, а не самовольничает: если бриф противоречит сам себе, он пишет об этом и не трогает запрещённый файл.
- Не больше двух возвратов: если сдача верная, а ломается одна строка, ведущий чинит её сам.
Что чиним — каждое улучшение против конкретного класса возвратов:
- тесты, которые задевает правка, сами попадают в разрешённые файлы — минус 14 возвратов;
- каждая команда проверки запускается вхолостую до прогона — минус 6;
- живые данные — обязательный критерий для задач с данными заказчика — минус 4;
- вёрстку принимаем по снимкам на телефоне и компьютере — минус 5;
- рабочие файлы задачи разрешены для чтения — минус 4 ложных тревоги.
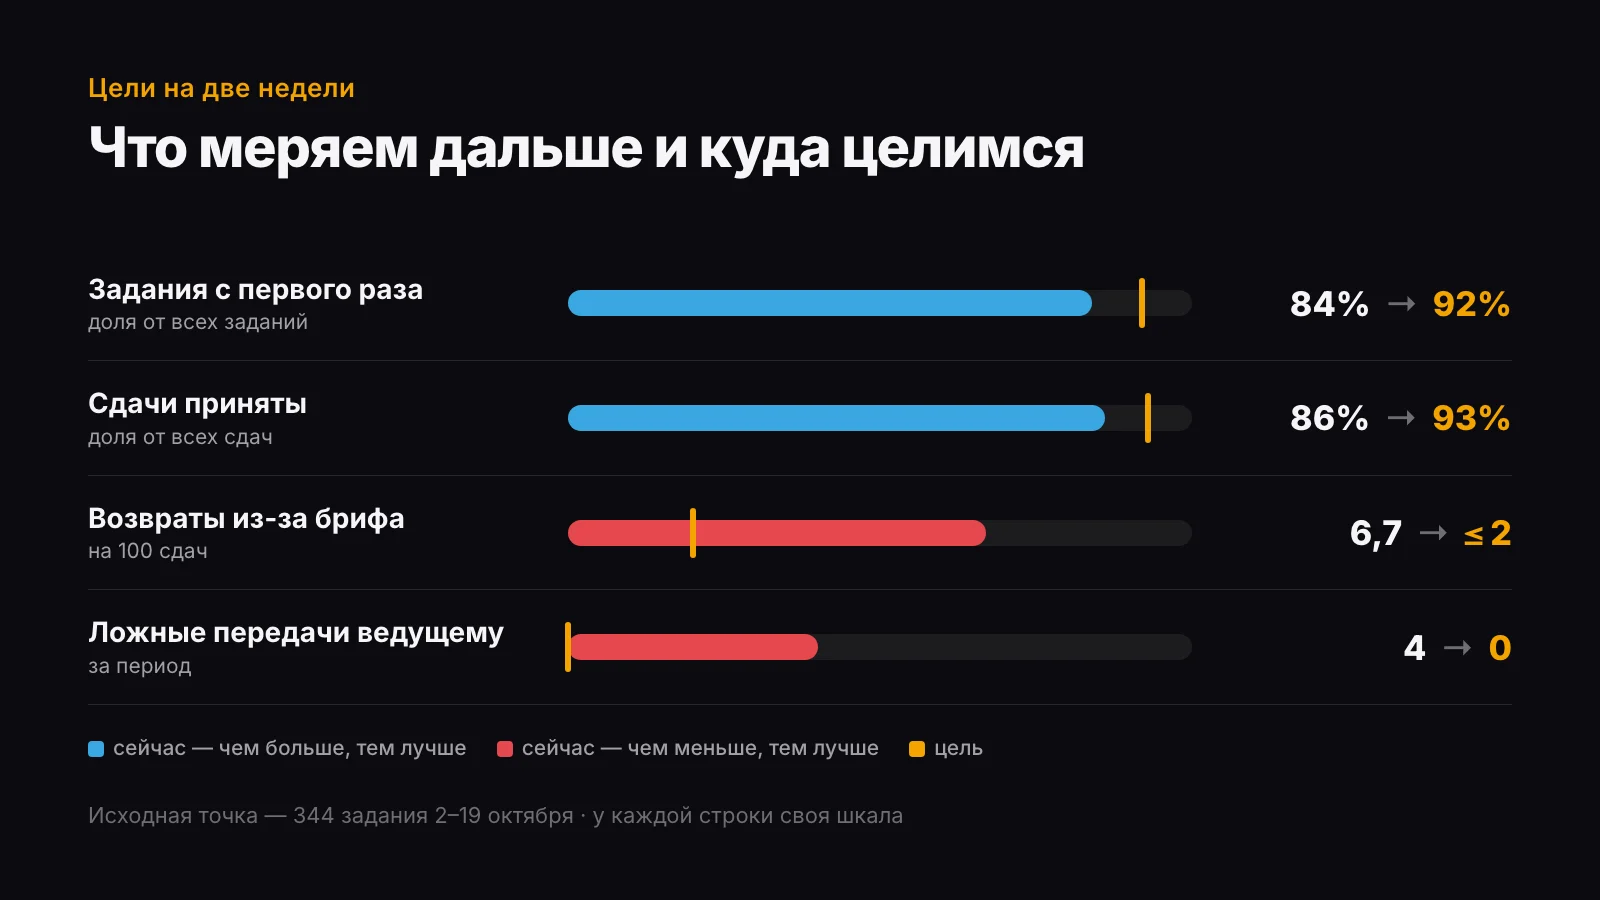
Цели посчитаны так: из сегодняшних цифр убраны случаи, которые закрывают пять улучшений, с запасом на новые ошибки.
Цифры открыты: агрегаты разбора лежат в JSON и CSV, их можно проверить и процитировать.
Что делегировать Codex, а что оставить себе?
Codex стоит отдавать код, преобразования данных, статические файлы и картинки; прод, секреты, данные клиентов и тексты для людей остаются у ведущего. Граница простая: всё, что можно проверить командой, можно отдать.
| Вид работы | Codex | Что остаётся ведущему | Почему |
|---|---|---|---|
| Код и тесты | ● | приёмка | результат проверяется командой |
| Преобразование данных | ● | прогон на живом наборе | синтетический тест не ловит крайние случаи |
| Картинки | ● | оценка глазом | машинного критерия нет |
| Вёрстка | ◐ | снимки экрана и приёмка | белый текст на белом поиск по коду не видит |
| Прод, деплой, git | ○ | всё | одна ошибка стоит часов восстановления |
| Секреты и данные клиентов | ○ | всё | агент читает всё, к чему есть доступ |
| Тексты для людей | ○ | всё | голос и ответственность автора |
● отдаём · ◐ отдаём черновик · ○ оставляем себе
Главное, что я понял за 18 дней: исполнитель — не узкое место. Узкое место — постановка. Почти половины возвратов не было бы, если бы ведущий до отправки проверял три вещи: есть ли в списке файлов тесты, которые заденет правка, нет ли в логике противоречий и выполнится ли каждая проверка как команда.
Хочешь так же — три способа
- Сделать самому. Пакет: контракт делегирования, проверки брифа, сторож, шаблоны брифа и приёмки. Первый блок уйдёт Codex в тот же вечер. Пакет готовится — напиши, пришлю, как выйдет.
- Сделать с нами. За неделю ставим делегирование в твой репозиторий, подстраиваем контракт под твой стек и проводим первый блок вместе.
- Обсудить в чате. Бесплатный чат для тех, кто сам ведёт агентов: вопросы, разборы брифов, новые версии контракта.
Для всех трёх — Telegram @bearded_illirian. А о том, куда всё это ведёт, — в статье от ИИ-инструментов к ИИ-сотрудникам.
Частые вопросы
Можно ли использовать Claude Code и Codex одновременно?
Да, если разделить роли. Claude Code сам ставит Codex задачи и принимает работу, Codex пишет код в своей копии репозитория. Так они работают параллельно: ведущий планирует следующую задачу, пока исполнитель пишет текущую.
Нужна ли подписка на оба инструмента?
Да, у каждой роли своя подписка. Это и есть смысл схемы: код пишется из лимита исполнителя, а лимит ведущего остаётся на планирование и приёмку.
Что Codex делает хуже всего?
По разбору 344 задач — крайние случаи на живых данных (14 ошибок в коде), вёрстку (5) и скорость на больших объёмах (3). Ещё чаще задачи возвращались из-за брифа — 28 случаев из 59.
Можно ли доверить агенту прод?
Нет. Прод, деплой, git, секреты и данные клиентов остаются у ведущего. Агент читает всё, к чему у него есть доступ, поэтому защищает не правило, а среда: песочница без сети и без записи за пределами рабочей копии.
Комментарии